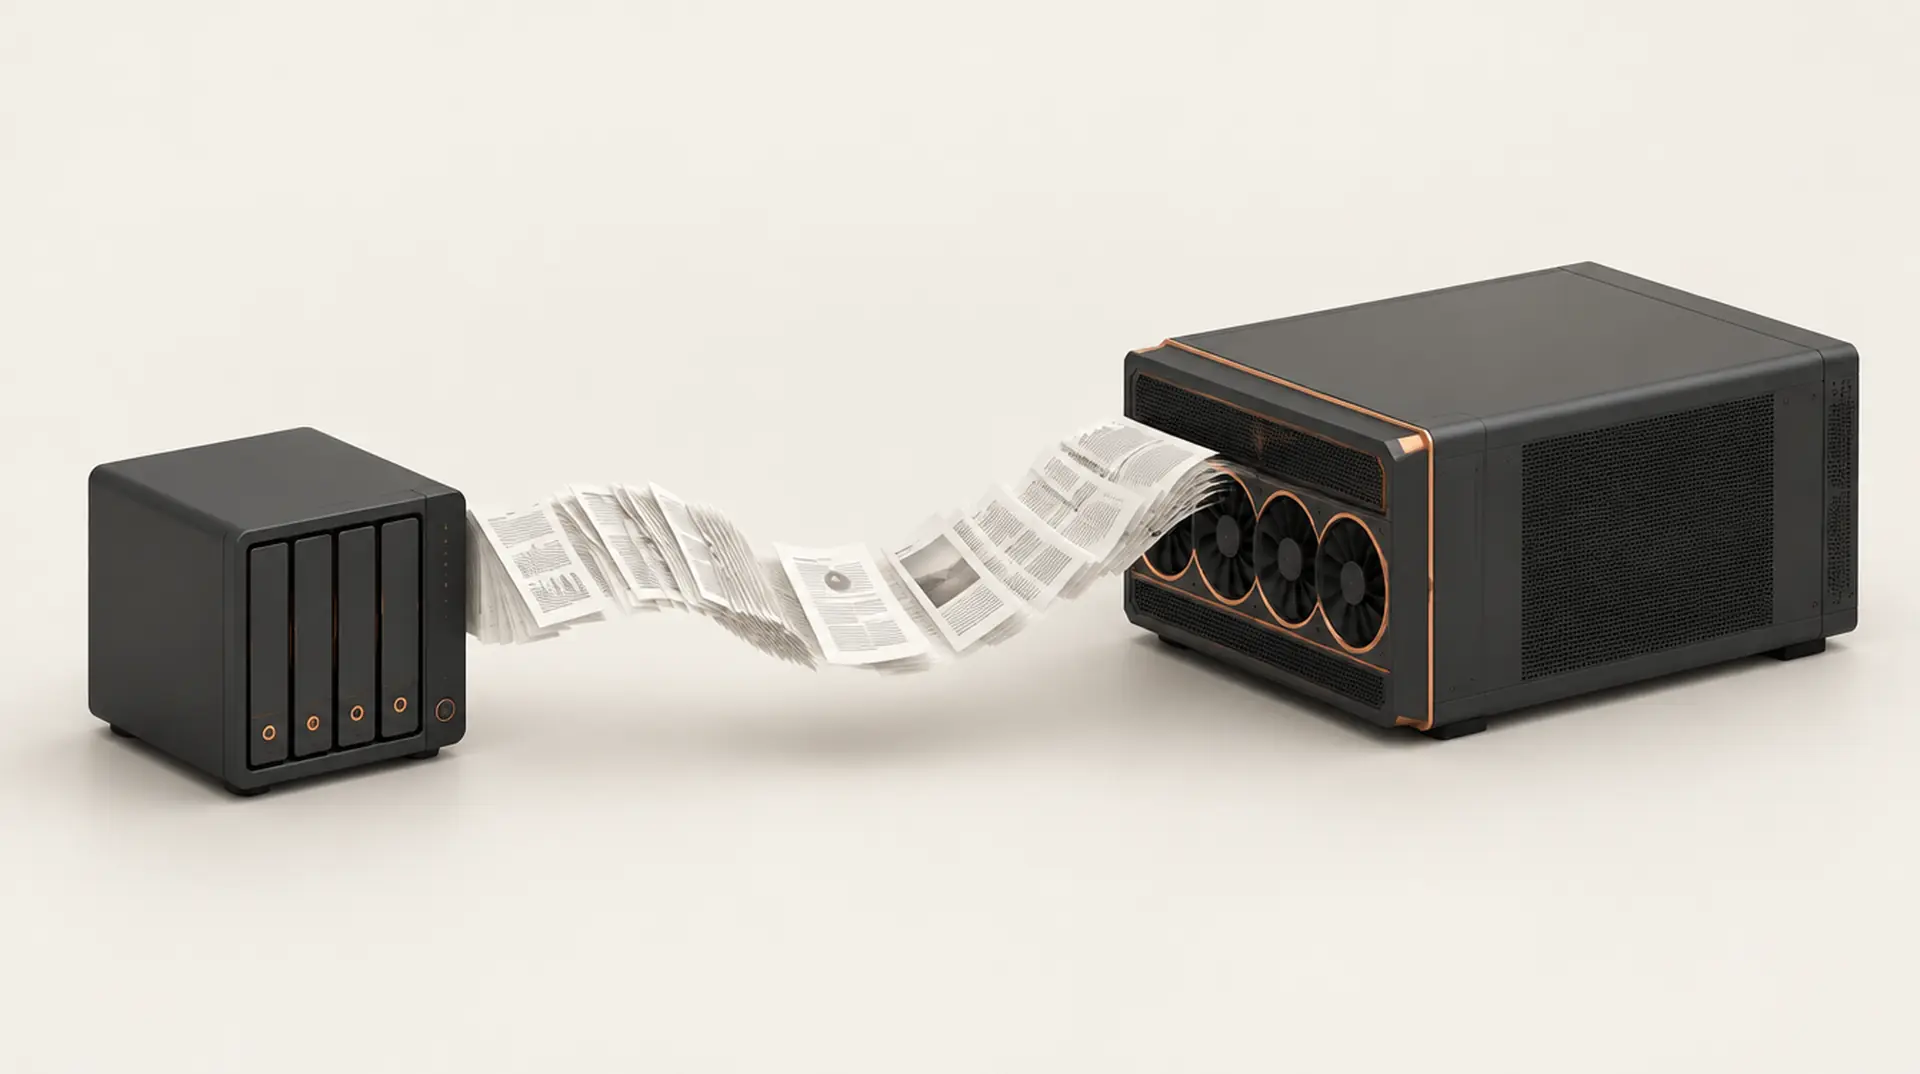
Die Frage kommt in fast jedem Erstgespräch mit einem Planungsbüro: „Unser NAS hat doch eine Suche. Warum reicht die nicht?"
Meistens reicht sie. Wer seine Verträge als Word-Dateien und seine Protokolle als durchsuchbare PDF ablegt, findet damit, was er sucht. Die Grenze liegt woanders, und sie hat mit der Suche wenig zu tun.
Sie liegt beim Anteil an Scans.
Was wirklich limitiert: nicht der Index, sondern die Texterkennung
Ein Suchindex über Textdateien ist billig. Ein paar hunderttausend Dokumente sind für eine moderne Indexierung kein Problem, und die Geräte von QNAP, Synology oder ein Windows Server mit aktivierter Indexierung bewältigen das zuverlässig.
Ein gescanntes PDF ist für diesen Index aber eine leere Seite. Es enthält ein Bild, keinen Text. Damit daraus etwas Durchsuchbares wird, muss jede Seite durch eine Texterkennung, und das ist eine völlig andere Art von Arbeit.
In Architektur- und Ingenieurbüros ist dieser Fall die Regel, nicht die Ausnahme. Bauakten aus den Neunzigern liegen als Scan vor. Bescheide kommen als Scan zurück. Prüfberichte werden unterschrieben, eingescannt und abgelegt. In den Beständen, die wir in Audits gesehen haben, liegt der Anteil an Bilddokumenten häufig zwischen dreißig und sechzig Prozent.
Was ein Büro-NAS im Planungsalltag trägt und was nicht
Auf dem Gerät im Serverschrank liegt bei den meisten Büros ohnehin schon alles: Projektordner nach Jahr und Nummer, Pläne in Indexständen, Scans aus zwanzig Jahren. Die Frage ist nicht, ob die Daten dort liegen, sondern ob sich daraus eine Suche bauen lässt, die eine Frage beantwortet statt einen Dateinamen zu finden.
Die Grenze verläuft an der Textmenge. Ein Gerät dieser Klasse schafft Titel, Pfade und Metadaten. Sobald hundert Genehmigungsplanungen als Bilddatei durchsucht werden sollen, jede mit Stempel und Handeintragungen, reicht es nicht mehr. Genau dort steckt aber die Vorgeschichte, die im Bestand über Wochen entscheidet.
Warum ein NAS diese Arbeit nicht nebenbei erledigt
Ein Netzwerkspeicher ist auf Speicher und Netzwerk ausgelegt. Sein Prozessor muss Dateidienste bedienen, Sicherungen fahren, Rechte prüfen und Datenträger verwalten. Das tut er gut, und dafür ist er gebaut.
Texterkennung in großem Umfang ist dagegen eine Aufgabe, die von paralleler Rechenleistung profitiert. Wo eine Grafikkarte hunderte Seiten gleichzeitig verarbeitet, arbeitet ein Speicherprozessor sie nacheinander ab, und zwar neben allem anderen, was er ohnehin tut.
Das ist kein Vorwurf an einen Hersteller. Es ist die Folge einer Entscheidung, die beim Entwurf des Geräts getroffen wurde, und sie war für den Hauptzweck richtig.
Für Sie hat sie eine praktische Folge: Wenn Sie mehr Rechenleistung für diesen Zweck brauchen, führt der Weg zurück zum Gerätehersteller und damit zu einer neuen Anschaffung. Ihre Entscheidung über KI im eigenen Haus ist an die Produktlinie eines Speicheranbieters gekoppelt.
Die drei Bauarten nebeneinander
| Frage | KI-Dienst aus der Cloud | KI-Funktion im NAS | Eigene Recheneinheit daneben |
|---|---|---|---|
| Wo verarbeitet wird | Beim Anbieter, oft mit Unterauftragnehmern | Auf dem Gerät im eigenen Haus | Auf Ihrer Maschine im eigenen Netz |
| Rechenleistung für Texterkennung | Vorhanden, jede Seite geht durch den Dienst | Die des Speichergeräts, geteilt mit allen Diensten | Eigene Grafikkarte, die nichts anderes tut |
| Bindung | An den Dienst und dessen Bedingungen | An Gerät und Generation des Herstellers | Keine, läuft neben jedem gängigen Server |
| Ergebnisform | Antwort, je nach Dienst mit oder ohne Quelle | Trefferliste zum Durchsehen | Antwort mit Datei, Seite und Fundstelle |
| Berechtigungen | Müssen getrennt nachgebildet werden | Aus dem Gerät vorhanden | Übernahme aus dem Active Directory |
Wie eine eigene Recheneinheit das löst
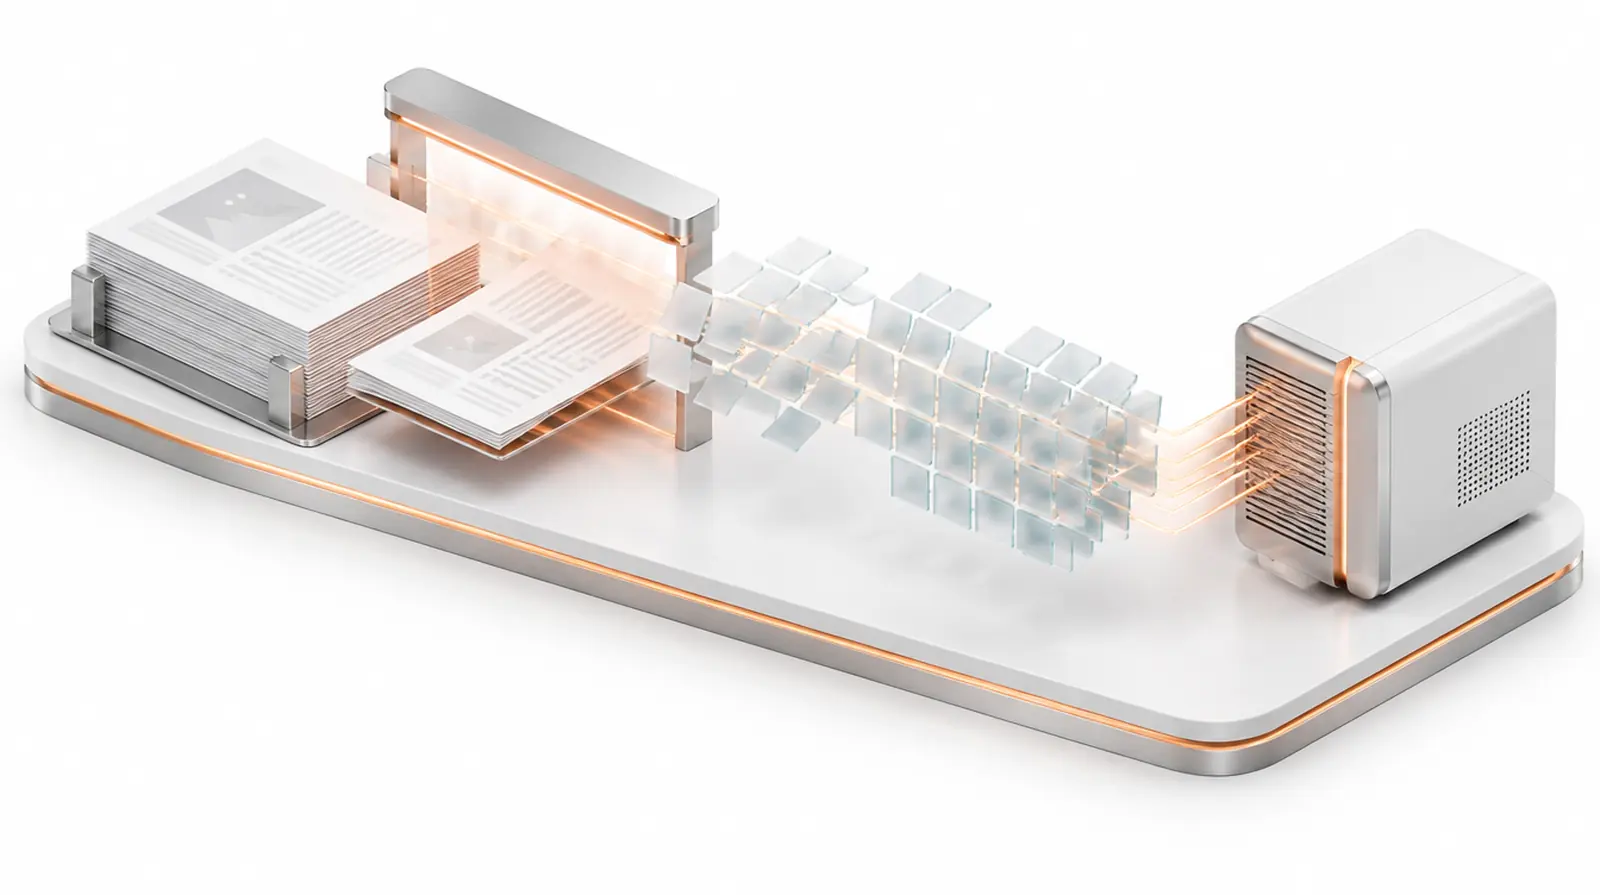
Der Aufbau ist unspektakulär, und genau das ist der Punkt. Eine Maschine mit einer Profi-Grafikkarte steht neben dem vorhandenen Server und greift über SMB oder NFS lesend auf die Freigaben zu, die Sie ihr zuweisen. Sie schreibt nichts zurück und verschiebt nichts.
Was sie tut, läuft in vier Schritten:
- Lesen. Der Bestand wird durchlaufen, Dateitypen werden erkannt, Bilddokumente werden aussortiert.
- Lesbar machen. Gescannte Seiten gehen durch die Texterkennung, einschließlich Tabellen und Schriftfeldern. Festgehalten wird, aus welcher Seite welche Textstelle stammt.
- Erschließen. Die Texte werden in Abschnitte zerlegt und inhaltlich abgelegt, damit die spätere Suche auch dann trifft, wenn in der Frage kein Wort aus dem Dokument vorkommt.
- Antworten. Bei einer Frage werden die passenden Abschnitte herausgesucht und einem offenen Sprachmodell mitgegeben, das daraus antwortet und die Fundstelle nennt.
Wie lange der erste Durchlauf dauert
Die ehrliche Antwort hängt nicht an der Dateizahl, sondern am Anteil der Scans. Reiner Text ist schnell abgearbeitet. Ein Archiv mit hohem Scananteil bestimmt die Dauer.
Als Anhaltspunkt aus unseren Projekten: Bei einer Million Dateien mit gemischtem Bestand liegt der erste vollständige Durchlauf bei 24 bis 72 Stunden. Bei sehr großen Archiven beginnen wir nicht mit allem, sondern mit den Ablagen, in denen täglich gesucht wird, und nehmen das Archiv danach dazu.
Was diese Zeit außerdem bestimmt, ist die Qualität der Vorlagen. Sauberer Druck wird nahezu fehlerfrei erkannt, ein Fax von 1998 nicht, und Handschrift bleibt schwierig. Deshalb gehört zur Einrichtung eine Stichprobe: fünfzig typische Dokumente aus Ihrem Bestand durch die Erkennung schicken und das Ergebnis ansehen, bevor irgendetwas anderes entschieden wird.
Datenschutz und Lizenzen, kurz und praktisch
Läuft die Verarbeitung auf Ihrer Maschine, entfällt der schwierigste Teil der Datenschutzprüfung: Es gibt keinen zusätzlichen Verarbeiter, keine Unterauftragnehmer und keine Übermittlung in ein Drittland. Was bleibt, ist Ihre eigene Pflicht, das Verzeichnis der Verarbeitungstätigkeiten zu ergänzen und die Rechtsgrundlage zu benennen.
Ein Punkt, der regelmäßig übersehen wird: Der Index enthält Ihre Inhalte in anderer Form. Er ist damit genauso schützenswert wie die Dokumente selbst und gehört in dieselbe Sicherung.
Beim Sprachmodell setzen wir offene Modelle mit freier Lizenz ein, ausgewählt an einem Testsatz aus Ihren eigenen Fragen. Welches gewinnt, entscheidet die Qualität auf Ihren Fachtexten und nicht eine Rangliste, die mit englischen Aufgaben gemessen wurde. Weil die Lizenzen offen sind, lässt sich das Modell später tauschen, und Ihr Bestand bleibt, wo er ist.
Normtexte nehmen wir ausdrücklich nicht in den Bestand auf. Sie sind urheberrechtlich geschützt und arbeitsplatzbezogen lizenziert. Was Sie im Alltag ohnehin suchen, ist nicht der Normtext, sondern Ihre eigene Anwendung davon: welche Fassung Sie in welchem Projekt zugrunde gelegt haben und wo Sie abgewichen sind.
Wann sich der Aufwand nicht lohnt
Wenn Ihr Bestand überschaubar ist, aus Textdateien besteht und Ihr vorhandenes Gerät die Suche darüber zuverlässig liefert, brauchen Sie nichts davon. Wir würden Ihnen in diesem Fall auch nichts verkaufen.
Interessant wird es an drei Stellen: wenn ein erheblicher Teil Ihres Archivs gescannt ist, wenn Fragen beantwortet werden sollen, deren Antwort in mehreren Dokumenten steckt, oder wenn die Berechtigungen sauber abgebildet sein müssen, weil Sie mit Mandanten- oder Auftraggeberdaten arbeiten.
◆Häufige Fragen
Ja, und viele Betriebe tun das. Die Volltextsuche bleibt für das schnelle Auffinden bekannter Dateien, die Appliance übernimmt die Fragen, deren Antwort verstreut liegt. Beides schließt sich nicht aus, weil die Appliance nur liest.
Der nächste Schritt
Wenn Sie wissen wollen, welche Größenordnung bei Ihnen zusammenkommt: Wir sehen uns im Erstgespräch an, welche Server bei Ihnen stehen, wie hoch der Scananteil ist und ob sich der Weg über eine eigene Recheneinheit lohnt. Fünfzehn Minuten reichen für die erste Einordnung, und wenn Ihre vorhandene Lösung passt, sagen wir Ihnen das.
Mehr zur Bauart steht auf der Seite zur Local AI Appliance, und wer konkret vergleicht, findet die Gegenüberstellungen unter Alternativen.