Lokale KI · kleine Modelle
Kleine Modelle lokal
auf dem Rechner, den Sie schon haben.
Nicht jede Aufgabe braucht ein großes Modell. Mails zuordnen, Dokumenttypen erkennen, Fristen herauslesen: Das schaffen kleine Modelle auf einem normalen Rechner. Sie sind der Grund, warum das große Modell Zeit für die schweren Fragen hat.
- Für wen
- Kleine Betriebe ohne Server und große Büros, die das Hauptmodell entlasten wollen
- Aufwand
- 15 Arbeitstage bis zur Spezifikation
- Förderung
- Wird für Ihr Bundesland geprüft
- Datenhaltung
- Auf dem vorhandenen Rechner oder neben dem Hauptmodell
- Erster Schritt
- Dreißig Minuten Erstgespräch per Video
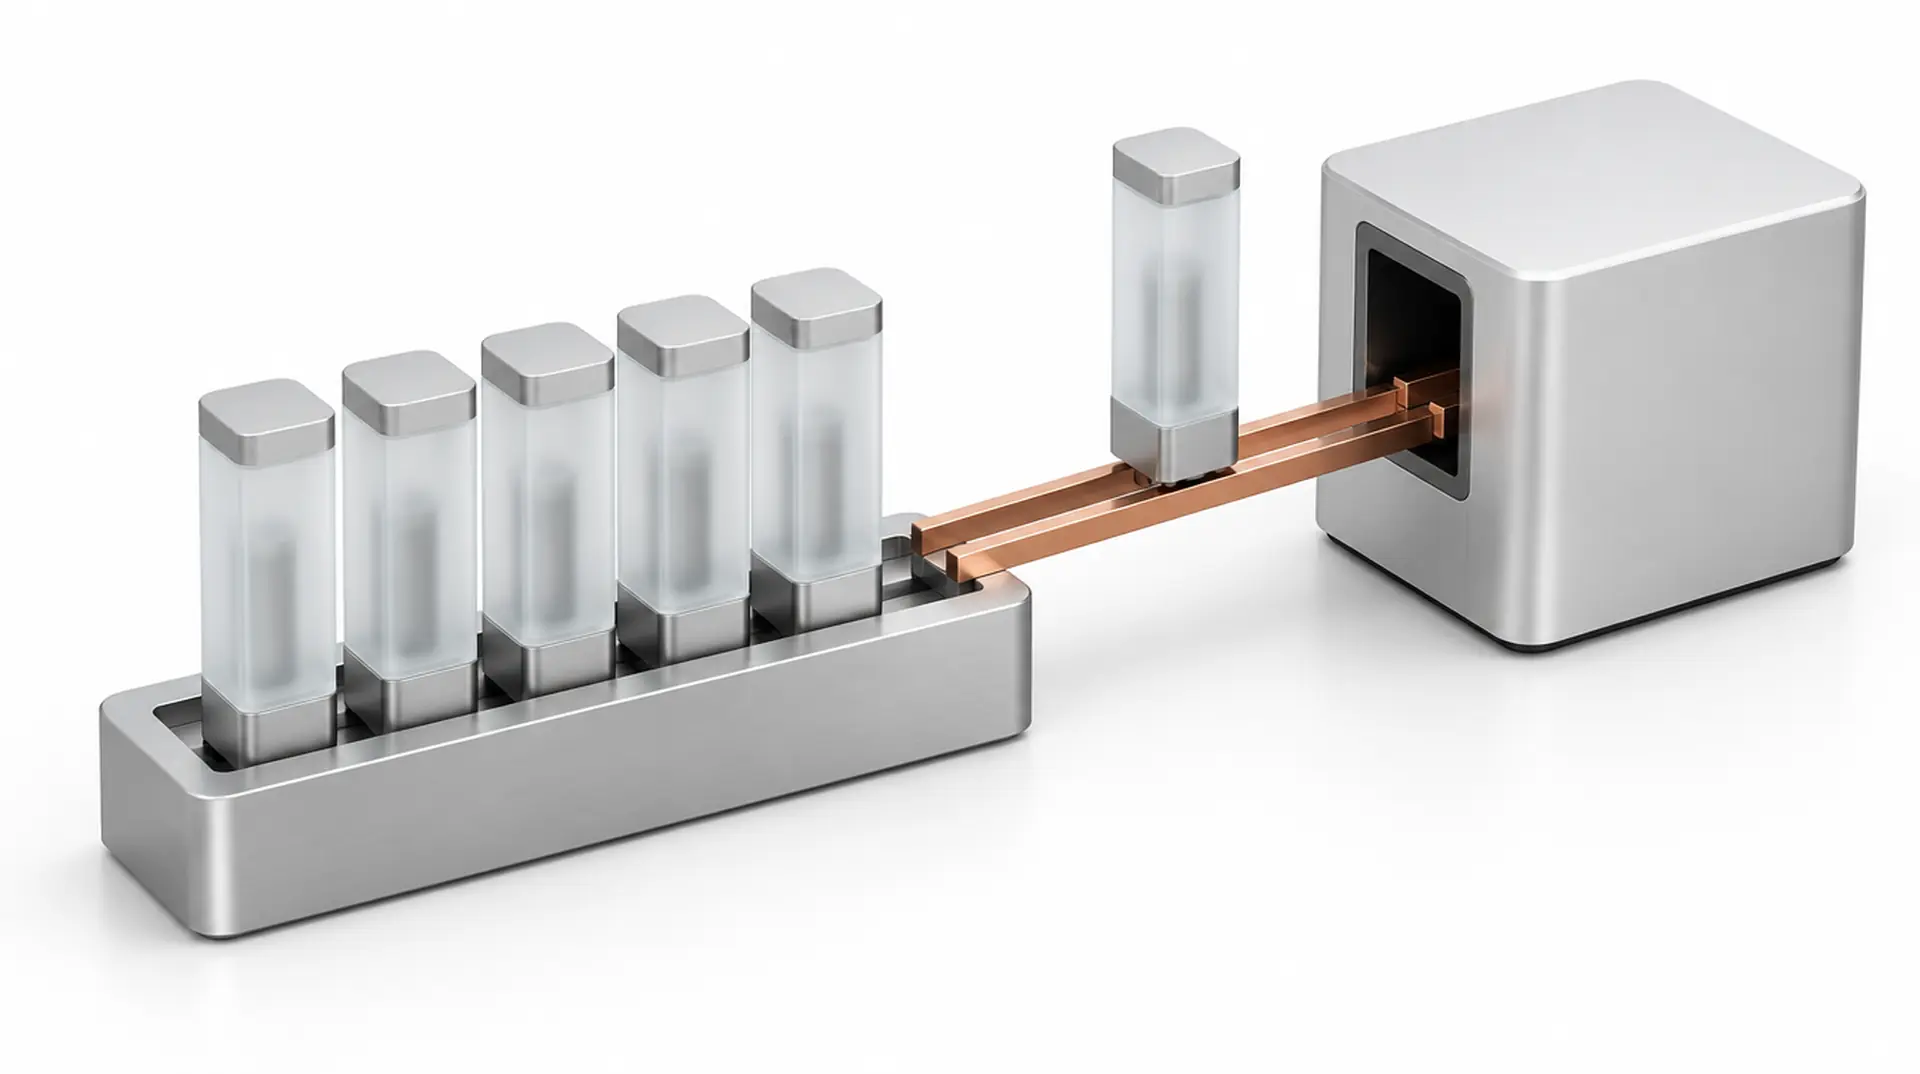
Kleine Sprachmodelle mit unter zehn Milliarden Parametern laufen lokal auf einer normalen CPU oder einer kleinen Grafikkarte, ohne Serverraum. Sie reichen für Zuordnung von Mails und Dokumenten, Klassifikation, Fristen erkennen und kurze Zusammenfassungen. Für Fachfragen über lange Akten und für Fachtexte sind sie zu klein. Im Zusammenspiel entlasten sie das große Modell, das dann nur die schweren Fragen bekommt.
Stand: September 2026
Wo kleine Modelle aufhören
Bei Fachfragen mit Quelle über hunderte Seiten, bei Fachtexten und bei allem, was Abwägung braucht, sind kleine Modelle überfordert und antworten trotzdem selbstbewusst. Deshalb bekommen sie bei uns klar umrissene Aufgaben mit prüfbarem Ergebnis, und alles andere geht an das große Modell. Ein kleines Modell als Hauptmodell fürs Büro ist die häufigste Enttäuschung, die wir sehen.
Wo kleine Modelle die bessere Wahl sind
Sie brauchen für einen großen Teil der Aufgaben im Betrieb kein großes Modell. Zuordnen, zusammenfassen, umformulieren, aus einer Notiz einen Entwurf machen: Dafür genügen kleine Modelle, und sie antworten schneller und lassen mehr gleichzeitige Nutzer auf derselben Karte zu.
Die Grenze liegt bei Aufgaben, die mehrere Quellen gegeneinander halten oder eine Herleitung über mehrere Schritte verlangen. Dort brechen kleine Modelle ein, und zwar nicht mit einer Fehlermeldung, sondern mit einer plausibel klingenden falschen Antwort. Genau deshalb gehört die Grenze im Testsatz abgesteckt.
In der Praxis ist deshalb die Aufteilung sinnvoll: das kleine Modell für die Masse, das größere für die schwierigen Fälle, und eine klare Regel, welche Anfrage wohin geht.
Ein kleines Modell bricht nicht mit einer Fehlermeldung ein, sondern mit einer plausiblen falschen Antwort.
Sechs Aufgaben, die kleine Modelle zuverlässig erledigen
Aus Betrieben, in denen ein kleines Modell die Vorarbeit macht und das große Modell nur bei Bedarf antwortet.
01 · Was hereinkommt
- Posteingang zuordnen: Projekt, Absender, Dringlichkeit, in Sekunden, auf der CPU
- Dokumenttyp erkennen: Rechnung, Bescheid, Protokoll, Plan, für die Ablage
02 · Was daraus wird
- Fristen und Beträge aus Standardschreiben herausziehen
- Kurze Zusammenfassungen von Mails und Notizen
03 · Was danach anders ist
- Erste Prüfung, ob eine Anfrage ins Fach passt, bevor das große Modell rechnet
- Betrieb auf einem kleinen Gerät im Büro, das Daten für das Hauptsystem vorsortiert
Für wen sich das lohnt
Kleine Betriebe
Sie haben keinen Serverraum. Ein kleines Modell auf dem vorhandenen Rechner sortiert Post und Ablage, das ist ein echter Anfang.
IT und Administration
Kleine Modelle laufen als Container auf normaler Hardware. Das große Modell bleibt für die schweren Fragen frei.
Sekretariat
Sie merken nur, dass die Post morgens sortiert ist. Welches Modell das war, ist egal.
Was wir dafür entwickeln
- 1
Post-Lotse: Posteingang, vom kleinen Modell vorsortiert, vom großen bei Bedarf beantwortet
Post-Lotse im Detail - 2
Kundenablage: CRM, erfassen, wer hereinkommt, Zuordnung durch das kleine Modell
Kundenablage im Detail - 3
Machbarkeits-Radar: Anfragen prüfen, erste Sichtung klein, Prüfung groß
Machbarkeits-Radar im Detail
So teilen wir die Arbeit zwischen klein und groß
- 01
Daten- und Netz-Audit
Was liegt wo, wie viele Scans, welche Rechtegruppen, welcher Serverraum. Fünfzehn Arbeitstage, am Ende die Spezifikation für Server und Software.
- 02
Aufbau im getrennten Netz
Server im eigenen Netzsegment, Modell lauffähig, Anmeldung über Ihr Active Directory, erster Test mit hundert echten Dokumenten.
- 03
Einlesen, Härten, Betrieb
Bestand einlesen, Rechte vererben, Sicherheitsprüfung durch Dritte, Pilot mit einer Abteilung, dann Betrieb mit monatlichem Bericht.
◆Fachwörter auf dieser Seite
Erklärt im Glossar
Im Detail als Fachartikel
Häufig gefragt
Reicht ein kleines Modell für unser Büro?
Für Sortieren, Zuordnen und kurze Texte ja. Für Fragen an Akten und Fachtexte nein. Die Kombination aus klein und groß ist meist die richtige.
Läuft das auf einem normalen PC?
Ja, Modelle bis etwa acht Milliarden Parameter laufen auf einer normalen CPU mit genug Arbeitsspeicher, langsam aber verlässlich. Eine kleine Grafikkarte macht sie schnell.
Welche kleinen Modelle nehmen Sie?
Kleine Varianten von Qwen, Gemma, Mistral und Llama, je nach Aufgabe und Sprache. Gemessen am Testsatz, nicht nach Namen.
Sind kleine Modelle sicherer?
Nicht sicherer, aber genügsamer. Sicherheit kommt aus Rechten, Netz und Betrieb, nicht aus der Modellgröße.
Gibt es Fördermittel für lokale KI?
Oft ja. Ob ein Zuschuss oder ein Darlehen greift, hängt an Ihrem Bundesland, an der Betriebsgröße und am Vorhaben. Hardware zählt in der Regel mit, wenn sie Teil des Vorhabens ist. Wir prüfen das vor dem Termin und sagen Ihnen, ob sich der Antragsaufwand lohnt.
Verwandte Seiten
Sehen wir uns Ihren Bestand an.
Dreißig Minuten, per Video oder Telefon. Danach wissen Sie, ob lokale KI bei Ihnen trägt und was der erste Schritt ist.